文章目錄
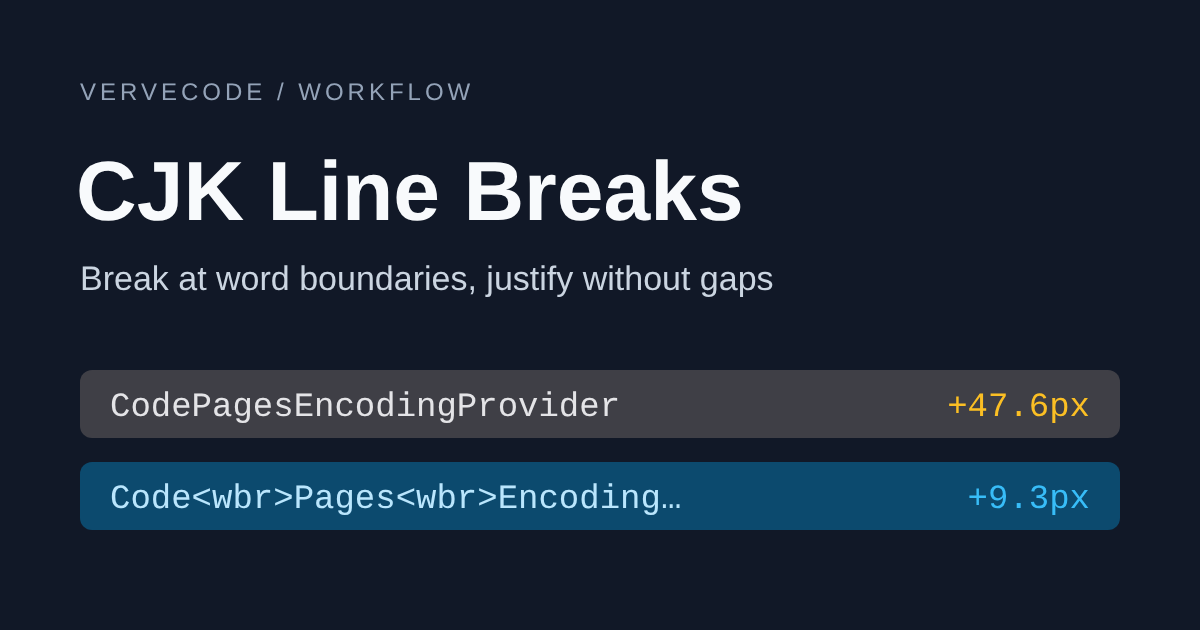
中文句子沒有空格,瀏覽器把任兩個字之間都當成可以換行的位置,因此標題放不下一行時,常常把「資料夾」斷成「資料」和「夾」,或讓「假人」分在兩行。段落改用左右對齊後,又會遇到另一種問題:句子裡的長英文單字放不進行尾,只好整個移到下一行,前一行剩下的幾個中文字被平均拉開,字和字之間空出將近三個字寬。這兩種情況都能在產生 HTML 時先標記好可以換行的位置來處理。
本站的標題從 2026 年 11 月起用這個做法換行,正文也在同月改成左右對齊,並套用本文替長英文字標記換行點的做法。
判斷要處理哪一種換行
如果標題在詞的中間換行,或左右對齊的段落字距被拉得很寬,可以先對照下表找出要處理的情況:
| 情況 | 現象 | 處理方式 |
|---|---|---|
| 中文標題放不下一行 | 詞被拆在兩行,例如「資料」與「夾」 | 在詞的邊界插入 <wbr>,標題改用 word-break: keep-all |
| 標題有全形冒號 | 放不下時在冒號前的主題中間換行 | 冒號前後各包成一段,放不下時先在冒號後換行 |
| 左右對齊的段落有長英文單字或網址 | 前一行的中文字距被拉寬,網址整串移到下一行 | 在單字與網址適合斷開的位置插入 <wbr> |
<wbr> 是 HTML 的換行建議點,本身不佔寬度,複製文字時也不會帶進剪貼簿。
只在詞的邊界換行
要讓標題只在詞的邊界換行,就要先替標題斷詞。CSS 的 word-break: auto-phrase 雖然能讓瀏覽器自己找片語邊界,但 Chrome 只對日文生效,在 Chromium 157 替繁體中文加上這個屬性,換行位置也沒有改變,因此中文仍要在產生 HTML 時自己斷詞。瀏覽器內建的 Intl 用 ICU 字典斷詞,Google 的 BudouX 則用機器學習模型把句子切成適合換行的片段,但兩者都會把某些詞切開。ICU 會把「資料夾」「假人」拆開,BudouX 則會把「快捷鍵」「容器」拆開。ICU 與 BudouX 拆錯的詞不同,只在兩者都認為是邊界的位置換行,兩邊拆錯的詞就都能保持完整。
BudouX 用 npm install budoux 安裝,而且只在建置時執行,因此讀者的瀏覽器不需要載入模型。本站用的是 BudouX 0.10.4,繁體中文模型用 load 載入。
把標題轉成 HTML 的函式會取兩種斷詞結果的交集,在交集的位置插入 <wbr>,但會避開讓標點落在行首、左括號落在行尾的位置:
1import { loadDefaultTraditionalChineseParser } from 'budoux';
2
3const budoux = loadDefaultTraditionalChineseParser();
4const icu = new Intl.Segmenter('zh-TW', { granularity: 'word' });
5const CJK_OR_MARK = /[ -〿㐀-鿿豈--]/;
6const NO_LINE_START = /[,。、:;!?)」』》〉】,.:;!?)\]]/;
7const NO_LINE_END = /[(「『《〈【(\[]/;
8
9const escape = (text: string) =>
10 text.replace(
11 /[&<>"]/g,
12 (c) => ({ '&': '&', '<': '<', '>': '>', '"': '"' })[c]!,
13 );
14
15const boundaries = (parts: Iterable<string>) => {
16 const set = new Set<number>();
17 let at = 0;
18 for (const part of parts) set.add((at += part.length));
19 return set;
20};
21
22export function phraseBreaks(text: string) {
23 const fromIcu = boundaries([...icu.segment(text)].map((s) => s.segment));
24 const fromBudoux = boundaries(budoux.parse(text));
25 let html = '';
26 for (let i = 0; i < text.length; i++) {
27 const before = text[i - 1],
28 after = text[i];
29 if (
30 i > 0 &&
31 fromIcu.has(i) &&
32 fromBudoux.has(i) &&
33 (CJK_OR_MARK.test(before) || CJK_OR_MARK.test(after)) &&
34 !/\s/.test(before + after) &&
35 !NO_LINE_START.test(after) &&
36 !NO_LINE_END.test(before)
37 )
38 html += '<wbr>';
39 html += escape(after);
40 }
41 return html;
42}
標題的 CSS 再加上 word-break: keep-all 後,中文字之間就不再是換行點,因此瀏覽器只會在 <wbr>、空格與標點後換行。overflow-wrap: break-word 則留給檔名這類沒有任何換行點、又比標題寬的字串,這些字串在必要時仍能斷開,不會超出版面:
1.post-title {
2  word-break: keep-all;
3  overflow-wrap: break-word;
4}
拿本站〈Minecraft 伺服器世界備份與還原〉的標題來看,在 390px 寬的手機畫面上,套用前的標題把「回到」拆在兩行:
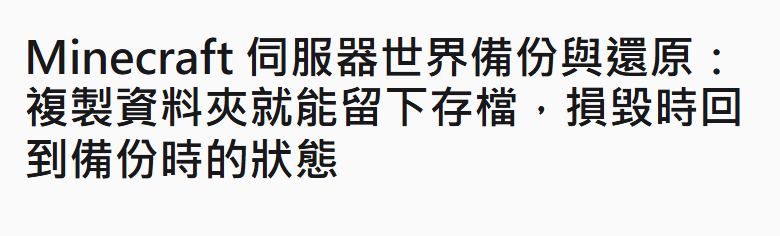
套用後,標題只在冒號與逗號後換行,「損毀時回到備份時的狀態」完整留在最後一行:
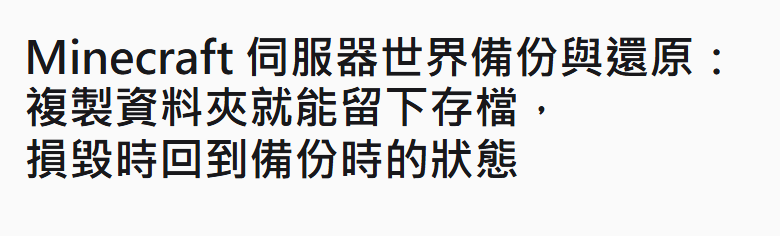
在冒號後優先換行
像「Prism Launcher 教學:安裝 CurseForge 模組包與處理被封鎖模組」這種「主題:結果」的標題,只標記詞的邊界時,放不下一行仍可能在冒號前的主題中間換行。把冒號前後各包成一個 inline-block 後,當標題放不下一行,瀏覽器就會先在兩段之間換行,兩段再各自用 text-wrap: balance,讓同一段裡每一行的長度接近,不會在最後一行只剩一兩個字:
1export function titleHTML(title: string) {
2  const colon = title.indexOf(':');
3  if (colon <= 0 || colon === title.length - 1) return phraseBreaks(title);
4  return `<span class="title-part">${phraseBreaks(title.slice(0, colon + 1))}</span><span class="title-part">${phraseBreaks(title.slice(colon + 1))}</span>`;
5}
1.title-part {
2  display: inline-block;
3  max-width: 100%;
4  text-wrap: balance;
5}
用 line-clamp 限制行數的標題分段後,每個 inline-block 會被當成一整行,截斷的位置就會出錯。本站的上一篇與下一篇連結就是這種標題,因此只標記詞的邊界,不分成兩段。
替長英文單字與網址加上換行點
段落左右對齊時,瀏覽器會把每行剩下的空間平均分給漢字之間與空格,英文字母之間則不分配空間(Chromium 的分配規則)。像 Code 這樣的長英文單字中間沒有任何換行點,放不進行尾時只能整個移到下一行,因此前一行會被拉開。在長英文單字適合斷開的位置插入 <wbr> 後,單字就能先放一部分在行尾,前一行也不會只剩幾個字。插入的位置依照網址與程式碼常見的斷法:網址的 // 之後,: 與 = 之後,.、/、\、_ 之前,以及小寫字母或數字接大寫字母的地方:
1export function codeBreaks(text: string) {
2  return escape(text)
3    .replace(/\/\/(?=.)/g, '//<wbr>')
4    .replace(/(?<=\w[:=])(?=\w)/g, '<wbr>')
5    .replace(/(?<=[\w)\]])(?=[./\\_])/g, '<wbr>')
6    .replace(/(?<=[a-z\d])(?=[A-Z])/g, '<wbr>');
7}
這個函式會把 Code 標成 Code<wbr>Pages<wbr>Encoding<wbr>Provider,把 Encoding 標成 Encoding<wbr>.Get<wbr>Encoding(950),把 Minecraft 指令裡的 minecraft: 標成 minecraft:<wbr>cow。escape 和標題用的是同一個函式,先跳脫再插入 <wbr>,原文裡的 <、& 才不會被當成標籤。
沒有包在行內程式碼裡的英文字也會遇到同樣的問題,例如正文直接寫出的「enable
1const LONG_TOKEN = /[A-Za-z0-9][\w./\\:=-]{11,}/g;
2
3export function textBreaks(text: string) {
4  let html = '',
5    at = 0;
6  for (const m of text.matchAll(LONG_TOKEN)) {
7    html += escape(text.slice(at, m.index)) + codeBreaks(m[0]);
8    at = m.index! + m[0].length;
9  }
10  return html + escape(text.slice(at));
11}
套用的範圍是段落與清單:行內程式碼與文字本身就是網址的連結用 code,其他文字用 text。程式碼區塊的 <pre> 不會換行,表格也不左右對齊,因此都不用處理。本站在 Markdown 轉成 HTML 後,會用 cheerio 再處理一次 HTML,換行點就加在同一個地方:
1$('p code, li code').each((_, el) => {
2  const code = $(el);
3  if (!code.children().length) code.html(codeBreaks(code.text()));
4});
5$('p a, li a').each((_, el) => {
6  const link = $(el);
7  if (!link.children().length && /^https?:\/\//.test(link.text()))
8    link.html(codeBreaks(link.text()));
9});
10// 其他文字逐層往下找,跳過行內程式碼
11const breakText = (parent: ReturnType<typeof $>): void => {
12  parent.contents().each((_, node) => {
13    if (node.type === 'text') {
14      if (/[A-Za-z0-9][\w./\\:=-]{11,}/.test(node.data))
15        $(node).replaceWith(textBreaks(node.data));
16    } else if (
17      node.type === 'tag' &&
18      !['code', 'kbd', 'pre'].includes(node.name)
19    )
20      breakText($(node));
21  });
22};
23for (const el of $('p, li').toArray())
24  if (!$(el).parents('p, li').length) breakText($(el));
段落的 CSS 改成左右對齊後,overflow-wrap: break-word 一樣留給沒有任何換行點的長字串。本站的文章容器裡還有目錄、延伸閱讀與留言,這些區塊要維持靠左,因此只選 Markdown 正文的直接子元素:
1.post-content:lang(zh) > p,
2.post-content:lang(zh) > blockquote p,
3.post-content:lang(zh) > :is(ul, ol) li {
4  text-align: justify;
5  overflow-wrap: break-word;
6}
:lang(zh) 讓英文頁維持靠左,英文段落左右對齊時,單字之間的空格會被拉寬。
手機的段落一行只放得下約 20 個中文字,即使有 <wbr>,/streamturbo 這類路徑的一段放不進行尾時,仍會留下好幾個字寬的空隙。因此左右對齊範圍裡的行內程式碼再加上 word-break: break-all,讓程式碼可以在任兩個字元之間換行,代價是程式碼偶爾會在字的中間斷開,例如「/strea」與「mturbo」:
1.post-content:lang(zh) > p code,
2.post-content:lang(zh) > blockquote p code,
3.post-content:lang(zh) > :is(ul, ol) li code {
4  word-break: break-all;
5}
標記換行點之後,長英文單字前的那一行不再被拉寬,網址也在 . 或 / 前換行,不再整串移到下一行。段落的最後一行維持靠左,不會被拉開。下面是實測紀錄裡的測試段落,在 390px 寬的手機畫面左右對齊的結果。沒有標記換行點時,Code 與網址都整個移到下一行,前一行的字距被拉開:
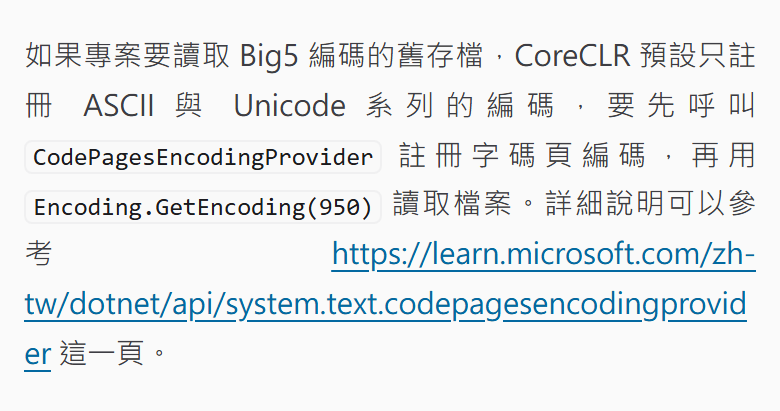
標記換行點並加上程式碼的 word-break: break-all 後,行內程式碼與網址都在行尾斷開,只剩「讀取檔案」那一行稍微拉開:
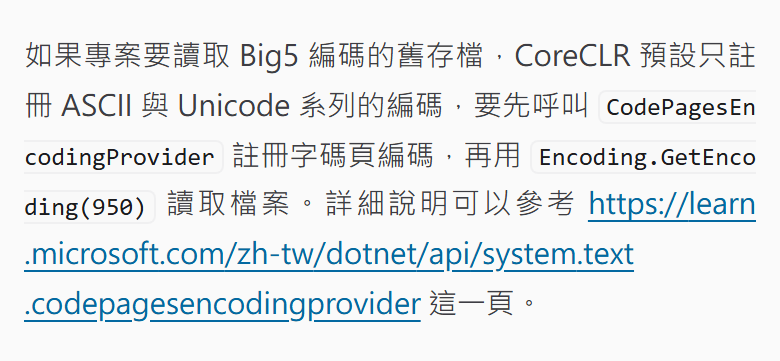
實測紀錄
標題的斷詞結果
標題的斷詞結果取自本站建置時用的 Node.js 26.13.1 內建的 Intl 與 BudouX 0.10.4。本站幾個標題片段在兩種斷詞下的切法如下:
| 標題片段 | ICU 的切法 | BudouX 的切法 |
|---|---|---|
| 複製資料夾就能 | 複製|資料|夾|就|能 | 複製資料夾|就能 |
| 假人指令 | 假|人|指令 | 假人|指令 |
| 顯卡重啟快捷鍵 | 顯|卡|重|啟|快捷|鍵 | 顯卡重啟快|捷鍵 |
| 關在開發容器 | 關在|開發|容器 | 關|在|開發容|器 |
左右對齊的字距
左右對齊的字距在 Linux 上的 Chromium 157 量測,段落寬度分別設成手機常見的 340px 與桌面常見的 700px,字型是文泉驛正黑,字級 17px、行高 1.8。測試段落的 Markdown 原文如下,「標記換行點」那組把兩段行內程式碼與網址連結的文字都換成 code 的輸出:
1如果專案要讀取 Big5 編碼的舊存檔,CoreCLR 預設只註冊 ASCII 與 Unicode 系列的編碼,要先呼叫 `CodePagesEncodingProvider` 註冊字碼頁編碼,再用 `Encoding.GetEncoding(950)` 讀取檔案。詳細說明可以參考 [https://learn.microsoft.com/zh-tw/dotnet/api/system.text.codepagesencodingprovider](https://learn.microsoft.com/zh-tw/dotnet/api/system.text.codepagesencodingprovider) 這一頁。
「每字最多多出」是對齊後漢字的寬度減去不對齊時的寬度,取整段的最大值:
| 段落寬度 | 條件 | 行數 | 每字最多多出 |
|---|---|---|---|
| 340px | 靠左 | 10 | 0px |
| 340px | 左右對齊 | 10 | 47.6px |
| 340px | 左右對齊,標記換行點 | 8 | 9.3px |
| 700px | 靠左 | 5 | 0px |
| 700px | 左右對齊 | 5 | 16.8px |
| 700px | 左右對齊,標記換行點 | 4 | 5.3px |
沒有標記換行點時,340px 寬的段落裡,有空格可以分攤的行,每個漢字多出 1.3 到 9.3px,長英文單字前的三行則多出 18.9 到 47.6px,最寬的一行字距接近三個字寬。
在 340px 寬、左右對齊的條件下,另外測試了幾個 CSS 屬性。只有 text-justify: inter-word 與 word-break: break-all 壓低了最寬的字距,但兩者都有副作用:
| 加上的 CSS | 每字最多多出 | 結果 |
|---|---|---|
text-justify: inter-character |
47.6px | 和預設相同,空間仍平均分給漢字之間 |
text-justify: inter-word |
0px | 漢字之間不分配空間,沒有空格的行改成靠左,有空格的行空格被拉寬到 34px |
overflow-wrap: anywhere |
47.6px | 只在單字比整行還寬時才斷開,CodePagesEncodingProvider 仍整個移到下一行 |
word-break: break-all |
2.2px | 字距正常,但英文單字在任意字母之間斷開,例如「CoreCL」與「R」 |
hyphens: auto(單字包在 lang="en") |
47.6px | 大寫開頭的英文單字不會斷字,CodePagesEncodingProvider 沒有加上連字號 |
text-wrap: pretty |
47.6px | 換行位置和預設相同 |
hyphens: auto 在同一個環境另外用 90px 寬的區塊測試,小寫的 internationalization 會斷成兩行並加上連字號,Internationalization 與 Code 則不會斷開,和 Chromium 原始碼裡不替大寫開頭的英文單字斷字的規則一致。
正文的截圖改在 Windows 11 的 Chromium 159 拍攝,視窗寬 390px,段落套用本站在手機寬度的字級與 Windows 的系統字型,因此換行位置和上表量測的段落不同。
全站文章的字距
本站正文改成左右對齊後,用同一個 Chromium 157 打開全站的中文文章,量測每個左右對齊的段落與清單項目裡,漢字最多多出的寬度。字型是這台測試機的系統字型,「只左右對齊」是把頁面上的 <wbr> 移除後再量測:
| 視窗寬度 | 條件 | 段落數 | 多出 10px 以上 | 多出 20px 以上 | 最多多出 |
|---|---|---|---|---|---|
| 390px | 只左右對齊 | 1652 | 64 | 26 | 71.4px |
| 390px | 加上換行點 | 1650 | 22 | 4 | 27.5px |
| 390px | 再加上程式碼的 break-all |
1647 | 10 | 2 | 27.5px |
| 1440px | 只左右對齊 | 1169 | 2 | 0 | 20.0px |
| 1440px | 加上換行點 | 1168 | 0 | 0 | 5.5px |
| 1440px | 再加上程式碼的 break-all |
1168 | 0 | 0 | 5.3px |
三項都套用後,手機寬度仍有 2 段多出 20px 以上,這幾行幾乎都是英文產品名稱,例如「Visual Studio Code、vscode.dev、GitHub」,只有兩三個漢字與標點可以分攤空間。
複製文字的結果也在 Chromium 157 確認過,選取含 <wbr> 的段落並複製後,剪貼簿裡的文字和原文相同。
總結
只要替中文標題在兩種斷詞結果都認為是詞邊界的位置標記換行點,替左右對齊段落裡的長英文單字與網址標記可以斷開的位置,瀏覽器就只會在這些地方換行。本站正文改成左右對齊後,在 Linux 的 Chromium 157 量測全站中文文章,手機寬度下多出 20px 以上的段落從 26 段降到 2 段,最寬的字距從每字多出 71.4px 降到 27.5px。
延伸閱讀