文章目錄
Pagefind 會在建置網站時產生索引檔,讀者直接在瀏覽器裡搜尋,因此靜態網站不需要另外架設搜尋伺服器。英文的單字之間有空格,中文句子卻沒有,因此 Pagefind 得先把句子切成一個個詞,這個步驟叫做斷詞。建立索引時要切一次,讀者輸入查詢後,瀏覽器也會再切一次。只要兩邊切出來的詞不一樣,搜尋就會漏掉有這個詞的文章,或列出根本沒有這個詞的文章。
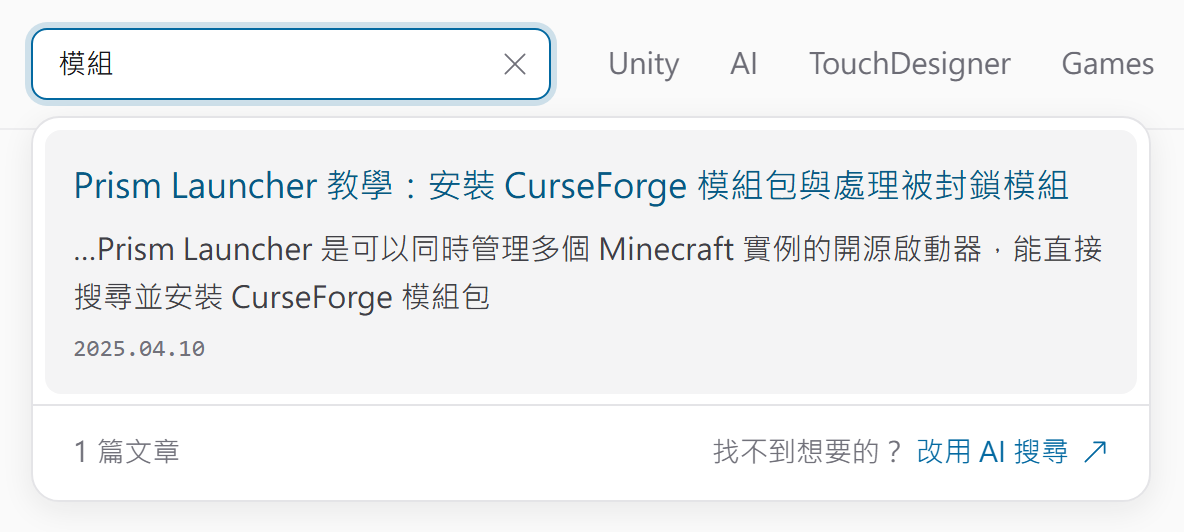
Pagefind 1.6.0 以前的版本在建立索引時,常把繁體中文詞拆成單字。本站在 2026 年 11 月導入 Pagefind 時,搜「模組」只找到 1 篇文章,但實際上有 14 篇提到「模組」。當時只好在建置時先用瀏覽器的那套規則把中文切好,再交給 Pagefind 建立索引。11 月 1 日發佈的 1.6.0 改用和瀏覽器相近的斷詞規則,只要升級並重新產生索引,大多數繁體中文詞就能正確找到,原本自己斷詞的程式也可以拿掉。
本站用 Astro 建置(從 Hugo 改寫成 Astro 的過程),搜尋畫面是用 Pagefind 的 JS API 自己做的面板。Pagefind 讀的是建置完成的 HTML,所以不管網站是用 Astro 還是 Hugo 產生,做法都一樣。文中的截圖都是在 Chromium 上拍的本站搜尋面板,每張只換掉背後的中文索引。
判斷網站是否需要處理
依 Pagefind 的版本和網站有沒有自己預先斷詞,中文的搜尋結果分成三種情況:
| 網站的情況 | 搜尋結果 | 處理方式 |
|---|---|---|
| 1.6.0 以前的版本,沒有預先斷詞 | 漏掉含有查詢詞的文章,也會列出無關的文章 | 升級 Pagefind |
| 1.6.0 以前的版本,已經預先斷詞 | 大多數查詢正確 | 升級後可以拿掉預先斷詞 |
| 1.6.0,沒有預先斷詞 | 大多數查詢正確 | 不用處理 |
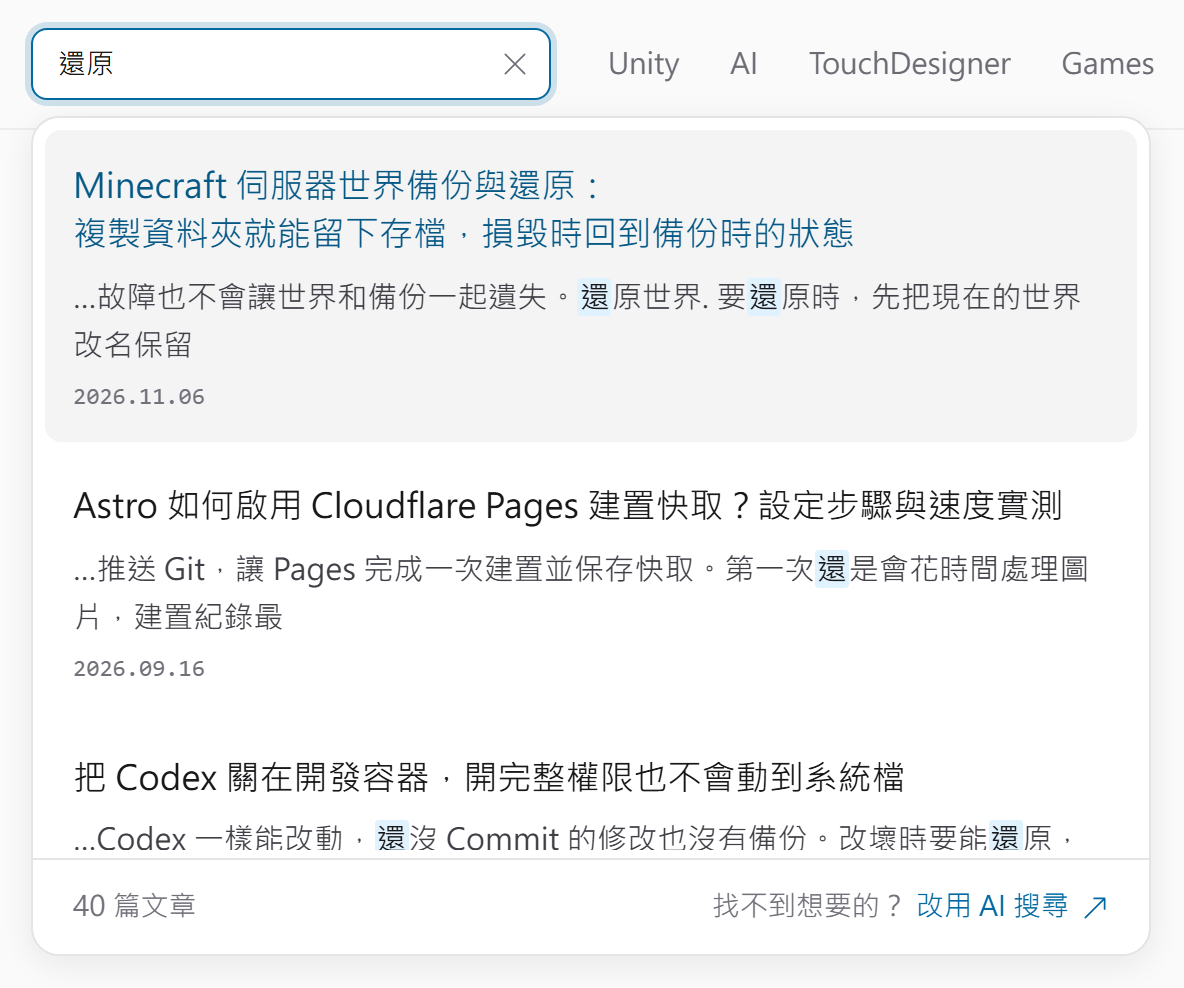
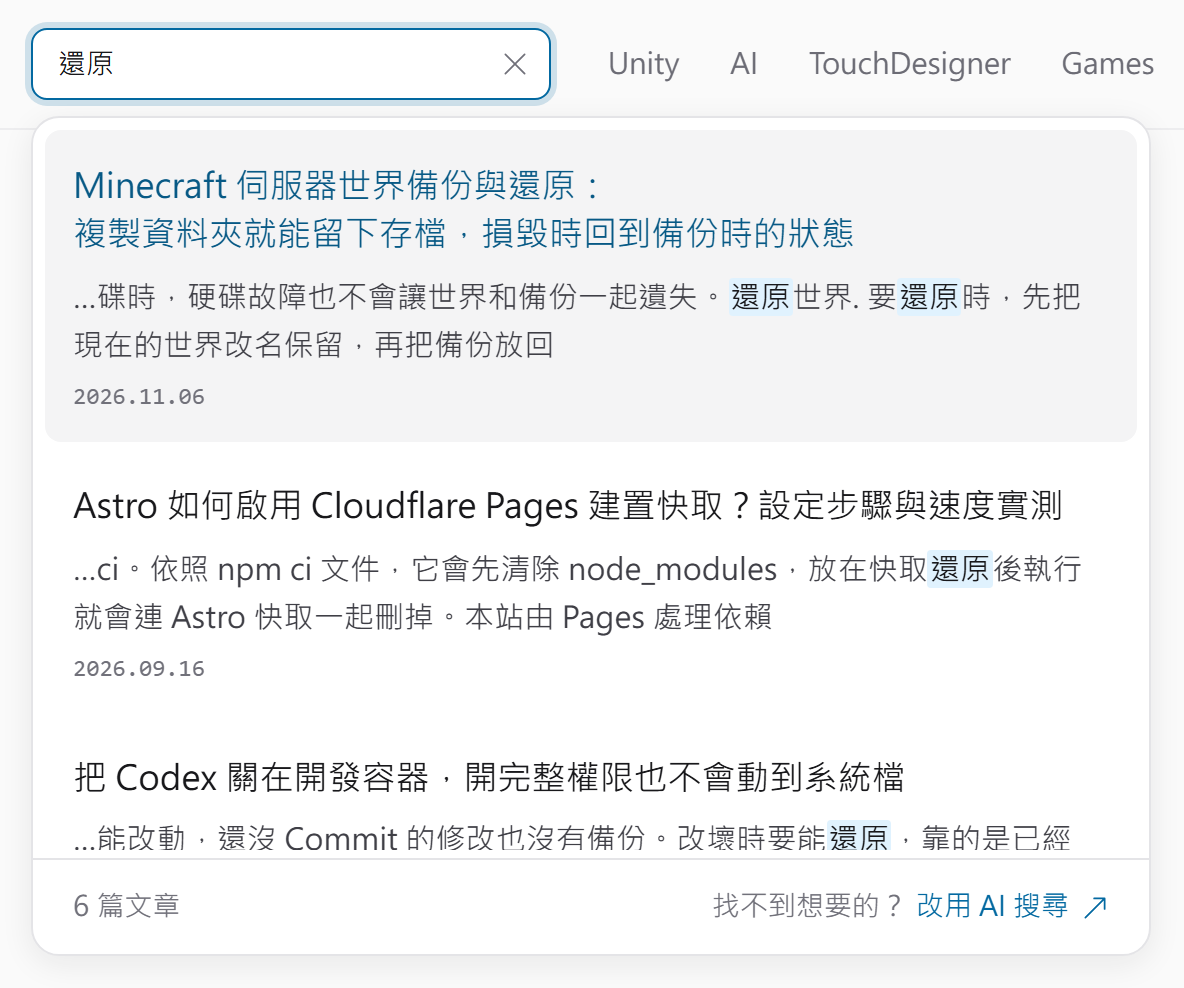
想確認自己的網站有沒有這個問題,可以搜網站裡常見的兩、三個字的詞,例如「還原」。如果摘要只標出一個「還」字,或結果裡出現「還沒」「還在」這類無關的句子,就是舊版切錯了。
升級並拿掉預先斷詞
Pagefind 只會替中文、日文、泰文的頁面斷詞,它看的是頁面 <html lang> 的值。本站中文頁寫的是 zh-TW,Pagefind 就會當成中文來切。Pagefind 的多語言文件 也寫到,只有 extended 版本能處理這幾種語言,用 npx pagefind 執行時預設就是這個版本。
-
在專案目錄升級套件:
1npm install --save-dev --save-exact pagefind@1.6.0Pagefind 的執行檔每個作業系統各有一個套件,lockfile 裡 7 個平台的套件會一起改成 1.6.0,因此 CI 在 Linux 上安裝的也是 1.6.0。
-
網站原本有預先斷詞的話,把它拿掉,改回 Pagefind 的內建斷詞:
- 建置時不再插入分隔用的空格,建立索引時也不要指定語言,讓 Pagefind 自己看
<html lang>。 - 搜尋時把讀者輸入的文字直接交給 Pagefind,它會在瀏覽器裡用
Intl.Segmenter自己切開中文查詢。 - 顯示結果前不必再清空格,因為 1.6.0 回傳的摘要就是原文,中文字之間不會多出空格。
沒有預先斷詞的網站可以跳過這一步,設定和搜尋程式都不用改。如果中文頁需要英文詞幹還原,就保留預先斷詞,原因寫在後面的「中文頁的英文查詢」。
- 建置時不再插入分隔用的空格,建立索引時也不要指定語言,讓 Pagefind 自己看
-
重新建置網站,Pagefind 會用新的規則重建索引。拿本站文章來測,中文索引從約 1,000 KB 變成約 1,162 KB,不過讀者搜尋時只會下載查詢詞所在的那幾塊。
-
搜尋同樣的詞確認結果。舊版搜「模組」只列出 1 篇:
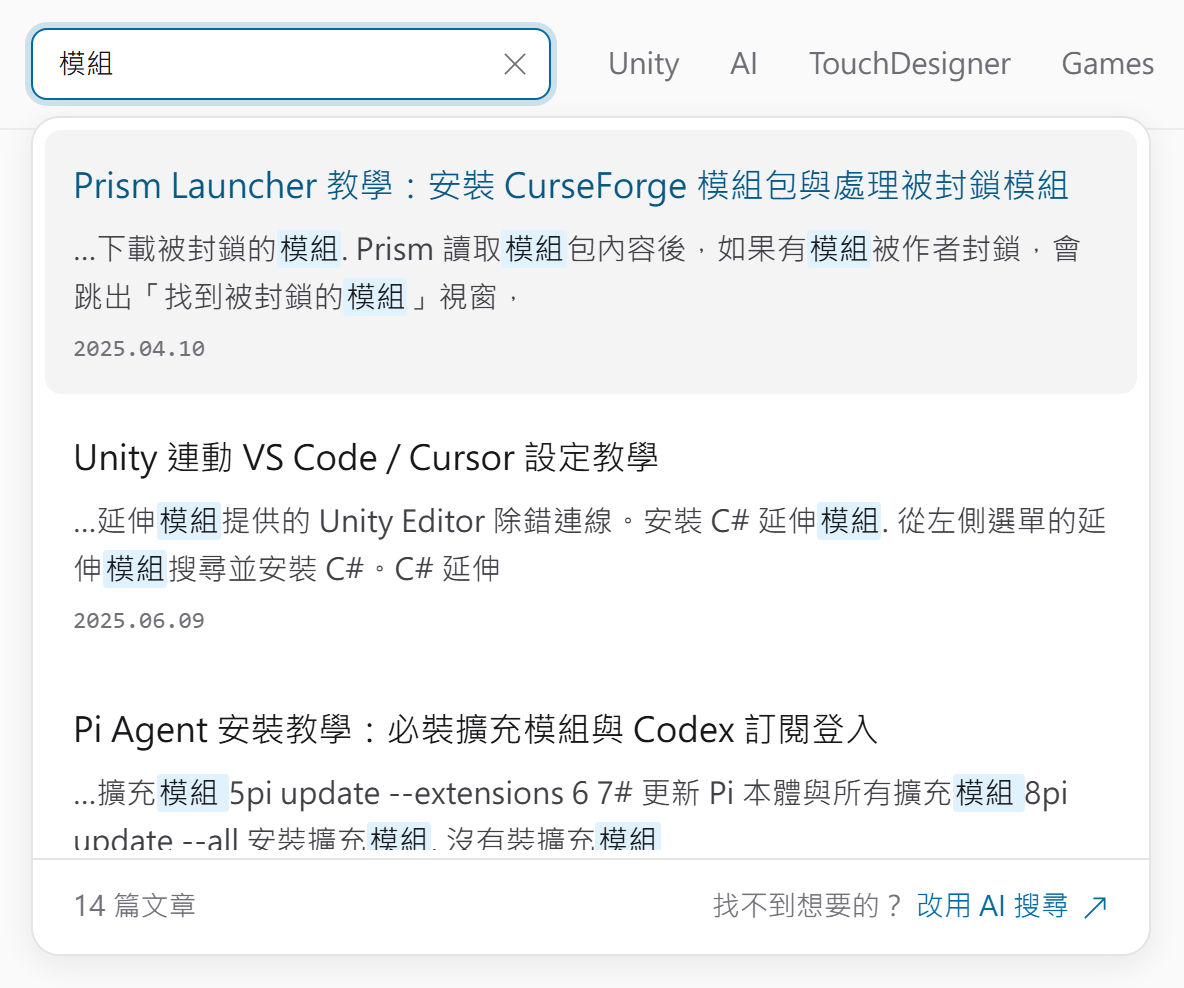
升級後 14 篇都會出現:
搜「還原」時,舊版反而列出 40 篇,其中 34 篇根本沒有「還原」。摘要只標出「還」字,連「還沒」「還是」這類句子也算成命中:
升級後只列出含有「還原」的 6 篇,摘要標出的也是完整的「還原」:
1.6.0 以前的預先斷詞
還不能升級的網站,可以用本站之前的做法:建置時自己先把中文切好,再把中文頁當成英文頁來建立索引。這樣 Pagefind 只會照空格切詞,不會用舊規則去切中文。
舊版的問題出在建立索引的那一端。1.5.2 用 charabia 函式庫斷詞,會把「還原」切成「還」和「原」,可是讀者輸入的「還原」在瀏覽器裡是一個完整的詞,結果只對得上「還」。1.6.0 改用 ICU4X(Unicode ICU 規則的 Rust 版本,PR #1383),切出來的詞和瀏覽器的 Intl.Segmenter 相近。Pagefind 的 1.6.0 更新說明 也提到,這次換掉斷詞函式庫,就是為了讓兩邊切得一致:
預先斷詞的做法,是讓建立索引和瀏覽器查詢都用 Intl.Segmenter 來切詞,兩邊切出來的詞就會一樣:
建置時,在中文的每個詞界插入 Unicode 的 Hair Space(U+200A)。Hair Space 是比一般空格窄的空白字元,原本用在排版上微調字距,這裡拿它當分隔符號,才不會和正文原本的空格混在一起。這一步只改記憶體裡的 HTML,讀者看到的頁面不受影響。只在 Pagefind 會收進索引的標題和正文插入,程式碼區塊不插。如果一段文字被連結這類行內元素切開,文字的頭尾也要補上分隔符號,否則「先」和連結裡的「備份」會黏成「先備份」:
1const segmenter = new Intl.Segmenter('zh-TW', { granularity: 'word' });
2// 中文字與全形標點
3const WIDE = '[\u3000-\u303f\u3400-\u9fff\uf900-\ufaff\uff00-\uffef]';
4const wide = new RegExp(WIDE);
5const SEPARATOR = '\u200a'; // Hair Space
6
7function presegment(text) {
8  let out = '';
9  let prev = '';
10  for (const { segment } of segmenter.segment(text)) {
11    const last = prev.at(-1);
12    const first = segment[0];
13    if (prev && !/\s/.test(last + first) && (wide.test(last) || wide.test(first))) {
14      out += SEPARATOR;
15    }
16    out += segment;
17    prev = segment;
18  }
19  // 行內元素的交界也要分開
20  if (wide.test(out[0] || '')) out = SEPARATOR + out;
21  if (wide.test(out.at(-1) || '')) out += SEPARATOR;
22  return out;
23}
每個文字節點都跑過 presegment() 後,再用 Node API 建立索引,並把語言指定成英文:
1import * as pagefind from 'pagefind';
2
3const { index } = await pagefind.createIndex({ forceLanguage: 'en' });
4await index.addHTMLFile({ url, content: html });
5await index.writeFiles({ outputPath: 'dist/pagefind/zh' });
索引的語言設成英文後,Pagefind 就不會幫忙切讀者的查詢,因此搜尋面板在送出查詢前,要自己用同一個 Intl.Segmenter,把讀者輸入的「伺服器備份」切成「伺服器 備份」:
1const pagefind = await import('/pagefind/zh/pagefind.js');
2
3const query = [...segmenter.segment(input)]
4  .filter((part) => part.isWordLike)
5  .map((part) => part.segment)
6  .join(' ');
7const results = await pagefind.search(query);
Pagefind 回傳標題和摘要時,會把 Hair Space 換成一般空格。顯示前要清掉兩個中文字之間、全形標點前後的空格,中文和英文之間原本就有的空格則保留。摘要用 <mark> 標出命中的詞,標籤兩側的空格也要一起清:
1const MARK = '[\u3000-\u303f\uff00-\uffef]'; // 全形標點
2const TAGS = '(?:</?mark>)*';
3const BETWEEN_WIDE = new RegExp(`(${WIDE}${TAGS}) +(?=${TAGS}${WIDE})`, 'g');
4const BEFORE_MARK = new RegExp(` +(?=${TAGS}${MARK})`, 'g');
5const AFTER_MARK = new RegExp(`(${MARK}${TAGS}) +`, 'g');
6
7function cleanSpaces(html) {
8  return html
9    .replaceAll(SEPARATOR, ' ')
10    .replace(BETWEEN_WIDE, '$1')
11    .replace(BEFORE_MARK, '')
12    .replace(AFTER_MARK, '$1')
13    .replaceAll('</mark><mark>', '');
14}
如果正文本來就在兩個中文字之間放了空格,這一步也會把它清掉。
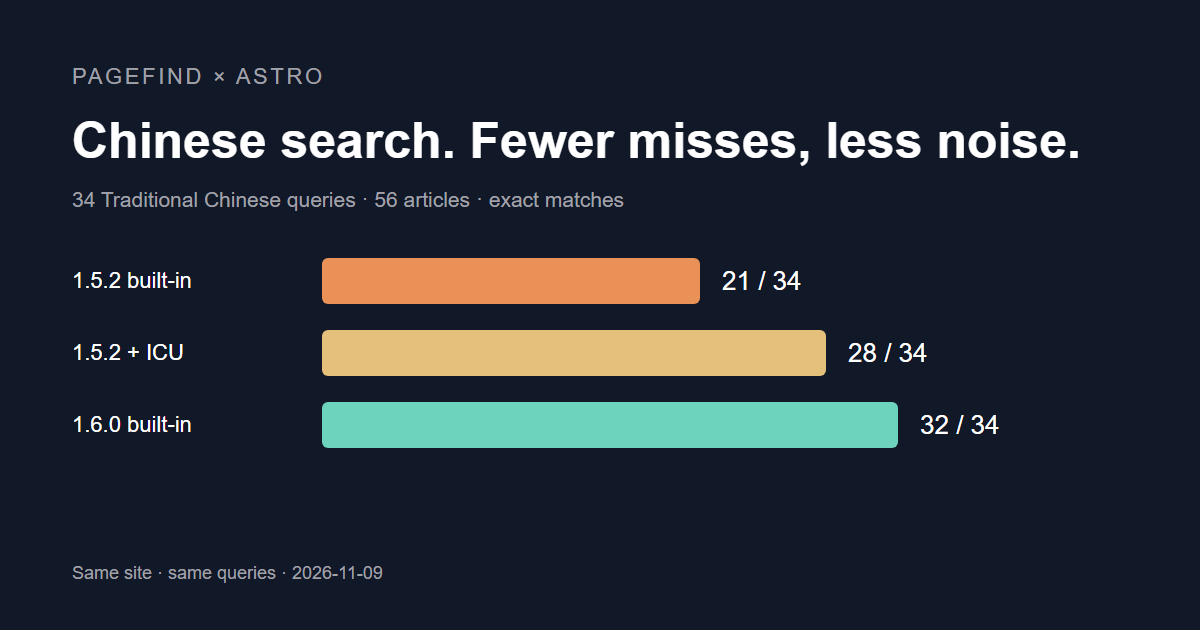
1.5.2 加上預先斷詞後,34 組查詢裡結果正確的從 21 組變成 28 組。剩下沒對上的,多半是因為 ICU 會看前後文來決定怎麼切。例如「授權限制」會切成「授權」和「限制」,搜「權限」就找不到這篇文章,搜「還原」時也因此少了 1 篇。這兩個詞改用 1.6.0 的內建斷詞,都能多找到 1 篇:
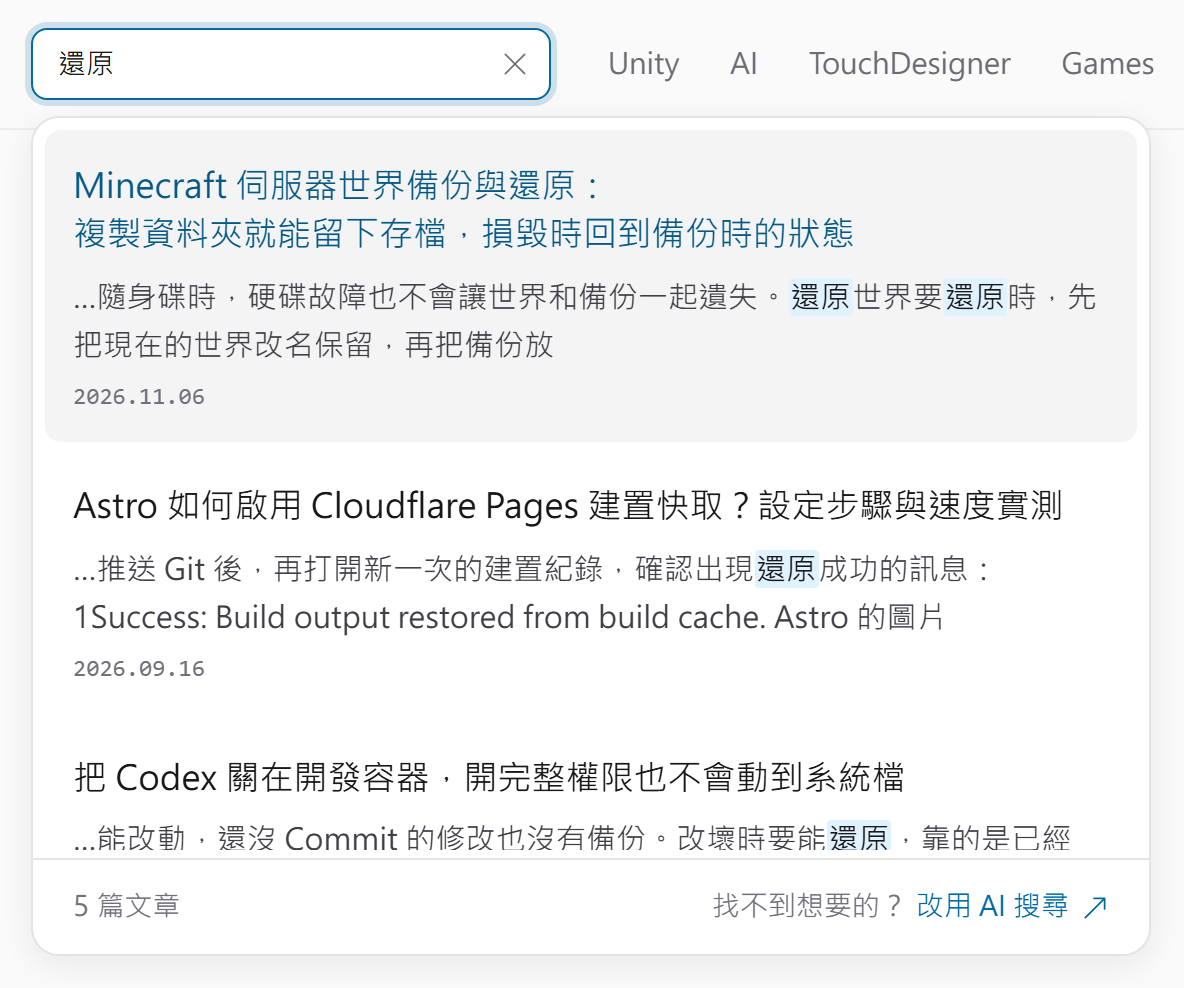
如果讀者瀏覽器裡的 ICU 版本和建置用的 Node.js 不同,少數詞也可能切得不一樣,結果是偶爾漏找幾篇,搜尋本身不會壞掉。
中文頁的英文查詢
中文頁用內建斷詞時,文中的英文單字一樣照空格分開。搜尋時不分大小寫,而且會比對字首,所以搜 install 也會找到寫 installing 的文章。不過中文索引不做英文的詞幹還原(Stemming),也就是不會把 installing 還原成 install,因此搜 installing 找不到只寫 install 的文章。官方文件 也寫明,中文、日文、泰文的索引不做詞幹還原。本站實測時,搜 install 找到 14 篇,搜 installing 只找到 1 篇。
本站有英文版,中文站的索引也收錄了每篇文章英文版的標題和正文,讓讀者在中文站用英文搜尋時,也能找到對應的中文文章。這類英文查詢需要詞幹還原,所以本站升級到 1.6.0 後仍保留預先斷詞,繼續把中文索引當成英文來建立。升級前後拿 34 組測試查詢,加上 4 組英文和跨語言查詢比對,這 38 組列出的文章完全一樣,只有 3 組的順序不同。
實測紀錄
測試用的是本站 2026 年 11 月 8 日建置的 56 篇繁體中文文章,四種做法都拿同一份建置結果,在記憶體裡產生索引,沒有加入英文版的內容。查詢先用 Intl.Segmenter('zh-TW') 切成詞,標題或正文裡每個詞都有出現的文章,就是這組查詢應該找到的文章,列出的文章和它完全一樣才算正確。這裡比對的是字串,因此「授權限制」也算含有「權限」。照詞界切詞的做法遇到這種跨詞界的字串,就算漏找。34 組查詢裡有單一中文詞、多個中文詞、沒加空格的詞組、英文字首,也有中英混合的查詢。
搜尋結果會錯在兩個地方:漏掉有查詢詞的文章,或列出和查詢詞無關的文章,後者就是雜訊。資訊檢索用召回率衡量前者,用精確率衡量後者。漏找會讓讀者以為網站沒有這篇文章,雜訊一多,真正要找的文章就會被擠到後面。
四種做法在 34 組查詢中結果正確的組數,以及中文索引的大小如下:
| 做法 | 結果正確的查詢 | 中文索引大小 |
|---|---|---|
| Pagefind 1.5.2 內建斷詞 | 21 / 34 | 1,000 KB |
| Pagefind 1.5.2 預先斷詞 | 28 / 34 | 1,037 KB |
| Pagefind 1.6.0 內建斷詞 | 32 / 34 | 1,162 KB |
| Pagefind 1.6.0 預先斷詞 | 28 / 34 | 1,033 KB |
兩種預先斷詞的結果完全相同,所以下表把它們合成一欄。數字是列出的文章篇數:
| 查詢 | 實際含有 | 1.5.2 內建斷詞 | 預先斷詞(兩版相同) | 1.6.0 內建斷詞 |
|---|---|---|---|---|
| 伺服器 | 16 | 5 | 16 | 16 |
| 模組 | 14 | 1 | 14 | 14 |
| 設定檔 | 36 | 1 | 35 | 35 |
| 開發容器 | 3 | 0 | 3 | 3 |
| 模組 伺服器 | 3 | 0 | 3 | 3 |
| 伺服器 備份 | 6 | 4 | 6 | 6 |
| 還原 | 6 | 40 | 5 | 6 |
| 世界 還原 | 1 | 11 | 1 | 1 |
| 權限 | 17 | 22 | 16 | 17 |
1.5.2 內建斷詞多出來的都是雜訊:「還原」的 40 篇裡有 34 篇無關,「世界 還原」的 11 篇裡有 10 篇無關,「權限」的 22 篇裡有 5 篇無關。
- 有 2 組查詢在四種做法下都不正確。「server.jar」會在句點切開,多列出 6 篇同時有 server 和 jar 的文章。「設定檔」少了 1 篇,因為那篇文章寫的是「設定檔案」,照前後文會切成「設定」和「檔案」。
- 英文字首查詢(Comfy、Clau、gamer、Touch)和中英混合查詢(Unity 授權、Minecraft 指令),四種做法的結果都一樣。
- 1.6.0 的內建斷詞也會比對詞的中段,搜「服器」會列出 18 篇文章,摘要標出的是「伺服器」。打錯字時雜訊也比較多,搜「權線」會列出 9 篇,預先斷詞則是 3 篇。
- 搜 commands 時,1.6.0 內建斷詞找到 4 篇,預先斷詞因為有詞幹還原,找到 12 篇。
總結
把 Pagefind 升級到新版並重新產生索引後,建立索引和瀏覽器查詢會用相近的規則切中文,原本自己預先斷詞的程式也可以拿掉。在本站的 34 組繁體中文查詢中,結果正確的從 1.5.2 的 21 組,增加到 1.6.0 內建斷詞的 32 組。
延伸閱讀