文章目錄
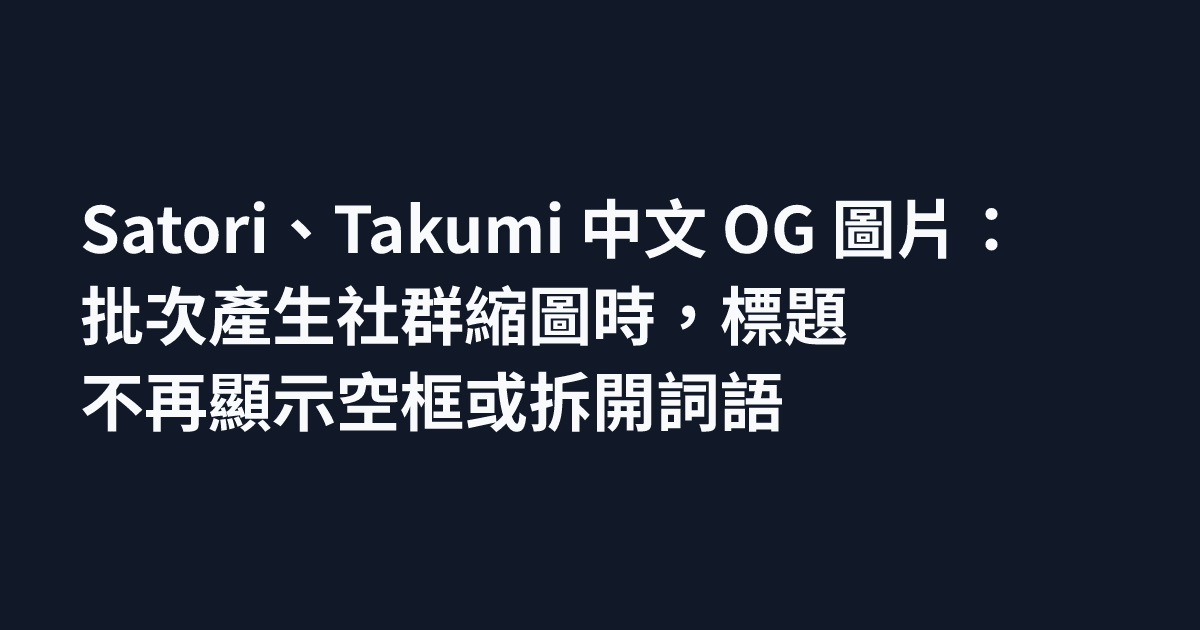
社群平台抓文章連結時,會顯示 og: 指定的縮圖。當我們想在建置時用同一份 HTML 範本替每篇文章產生縮圖,又不想為此開啟瀏覽器截圖,就可以用 Takumi 或 Satori,兩者都能直接把 HTML 或 JSX 畫成圖片。但兩者都不會讀取系統字型,沒有載入中文字型時,標題的中文只會畫成一排空框。載入字型後,標題又會在詞的中間換行,例如把「沒有」拆成「沒」與「有」。本文以 Takumi 為主,處理這兩個問題後,用本站 77 個標題產生的縮圖都只在詞界換行。
測試環境是 Linux、Node.js 22.23.5、Takumi 2.22.0 與 Satori 0.63.2,縮圖尺寸 1200 × 630,標題字級 64px。
判斷要處理的問題
縮圖的標題會遇到下面兩種問題,Takumi 與 Satori 都會發生。表中是 Takumi 的處理方式,Satori 的做法見〈設定 Satori 的中文換行〉:
| 情況 | 縮圖上的現象 | 處理方式 |
|---|---|---|
| 沒有載入中文字型 | 中文全部畫成空框 | 在 fonts 傳入繁體中文字型 |
| 標題放不下一行 | 在詞的中間換行 | 在詞的邊界插入零寬空格,並設定 word-break: keep-all |
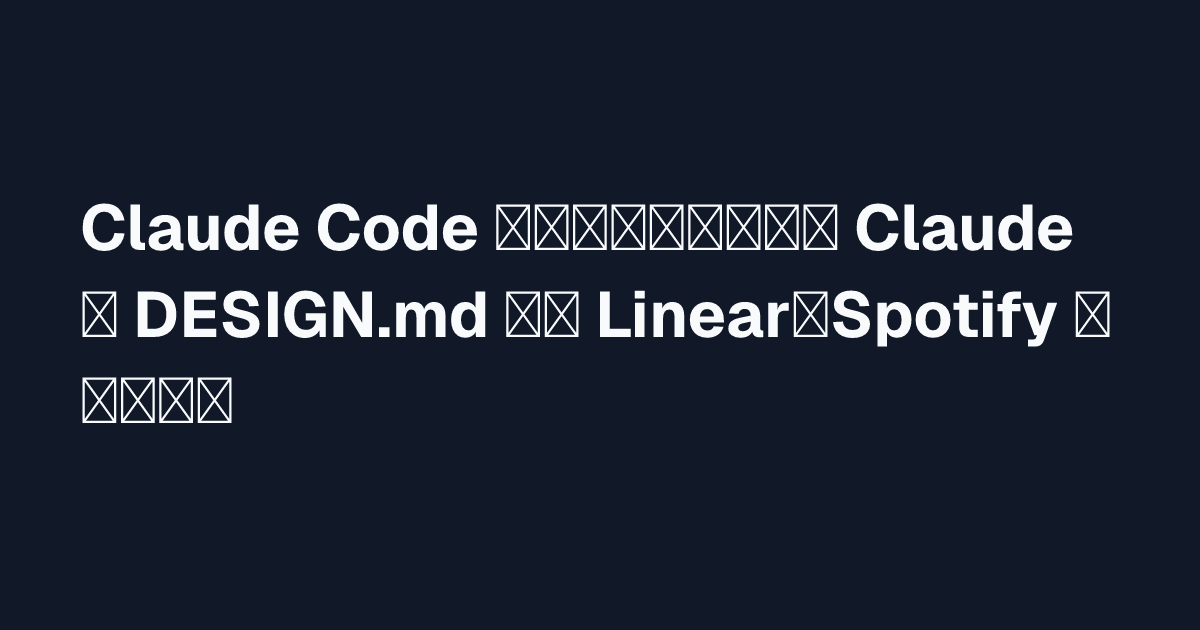
沒有載入中文字型時,標題裡的英文仍然正常顯示,中文則會變成空框,因為 Takumi 只內建涵蓋拉丁字母的 Geist 字型:
載入繁體中文字型
先安裝 Takumi,以及下一步斷詞要用的 budoux:
1npm install takumi-js budoux
Takumi 的字型文件寫明原生版本可以讀取 TTF、OTF、WOFF、WOFF2 與 TTC,但永遠不會讀取系統字型,因此字型檔要放在專案裡,再從 fonts 傳進去。本文用的是從 Google Fonts 的 Noto Sans TC 下載的 Bold 字重靜態 TTF,大小約 7 MB:
1import { render } from 'takumi-js';
2import { readFile, writeFile } from 'node:fs/promises';
3
4const font = await readFile('NotoSansTC-Bold.ttf');
5const png = await render(
6  `<div style="font-family:'Noto Sans TC';font-size:64px;font-weight:700">繁體中文縮圖</div>`,
7  {
8    width: 1200,
9    height: 630,
10    fonts: [{ name: 'Noto Sans TC', data: font, weight: 700 }],
11  },
12);
13await writeFile('title.png', png);
name 要和 HTML 裡 font-family 寫的名稱相同,Takumi 才會用這個字型畫出標題。執行後打開 title,看到中文正常顯示就代表字型載入成功。字型檔只要讀取一次,之後每張縮圖都傳入同一份資料。
在詞的邊界插入零寬空格
載入字型後,Takumi 和瀏覽器一樣,會把任兩個中文字之間都當成換行點。如果要讓標題只在詞界換行,就要在詞的邊界用零寬空格(U+200B)標記換行點。零寬空格不佔寬度,Takumi 與 Satori 都會在它的位置換行。
斷詞用瀏覽器與 Node.js 內建的 Intl,再加上 Google 的 BudouX。兩者都會把某些詞切開,例如 Intl 會把「顯卡」切成「顯」與「卡」、把「資料夾」切成「資料」與「夾」,BudouX 則會把「快捷鍵」切成「快」與「捷鍵」。兩者切錯的位置不同,因此只要在兩者都認為是詞界的位置插入零寬空格,這些詞就能保持完整。拿「顯卡重啟快捷鍵,複製資料夾」來看,兩者都同意的位置只有逗號後面:
下面的函式取兩種斷詞結果的交集,並避開會讓標點落在行首、左括號落在行尾的位置。函式裡的 '\u200 就是零寬空格,寫成跳脫字元,編輯器與格式化工具才不會把看不見的字元清掉:
1import { loadDefaultTraditionalChineseParser } from 'budoux';
2
3const budoux = loadDefaultTraditionalChineseParser();
4const icu = new Intl.Segmenter('zh-TW', { granularity: 'word' });
5const CJK_OR_MARK = /[ -〿㐀-鿿豈--]/;
6const NO_LINE_START = /[,。、:;!?)」』》〉】,.:;!?)\]]/;
7const NO_LINE_END = /[(「『《〈【(\[]/;
8
9const boundaries = (parts) => {
10 const set = new Set();
11 let at = 0;
12 for (const part of parts) set.add((at += part.length));
13 return set;
14};
15
16function phraseBreaks(text) {
17 const fromIcu = boundaries([...icu.segment(text)].map((s) => s.segment));
18 const fromBudoux = boundaries(budoux.parse(text));
19 let out = '';
20 for (let i = 0; i < text.length; i++) {
21 const before = text[i - 1],
22 after = text[i];
23 if (
24 i > 0 &&
25 fromIcu.has(i) &&
26 fromBudoux.has(i) &&
27 (CJK_OR_MARK.test(before) || CJK_OR_MARK.test(after)) &&
28 !/\s/.test(before + after) &&
29 !NO_LINE_START.test(after) &&
30 !NO_LINE_END.test(before)
31 )
32 out += '\u200B';
33 out += after;
34 }
35 return out;
36}
範本的標題再加上 word-break: keep-all,取消中文字之間的換行點,Takumi 就只會在零寬空格、空格與標點後換行。text-wrap: balance 則會讓每一行的長度接近,不設定也不影響換行位置。同一個標題處理前,「沒有」與「推送」都被拆開:
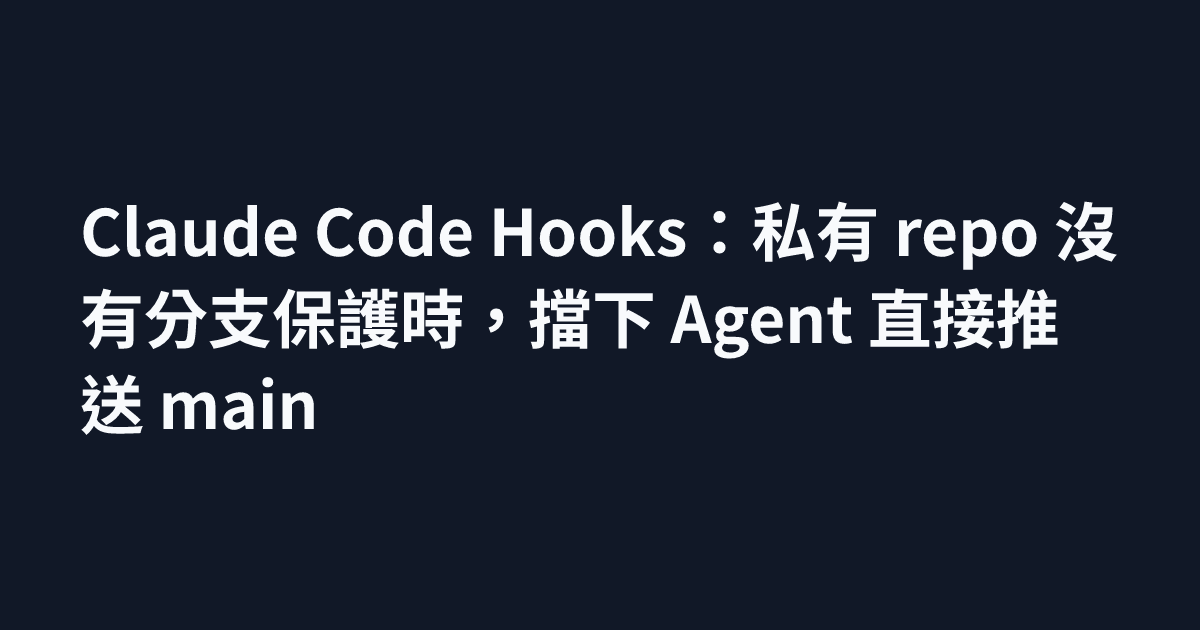
處理後,同一個標題改在冒號與逗號後換行:
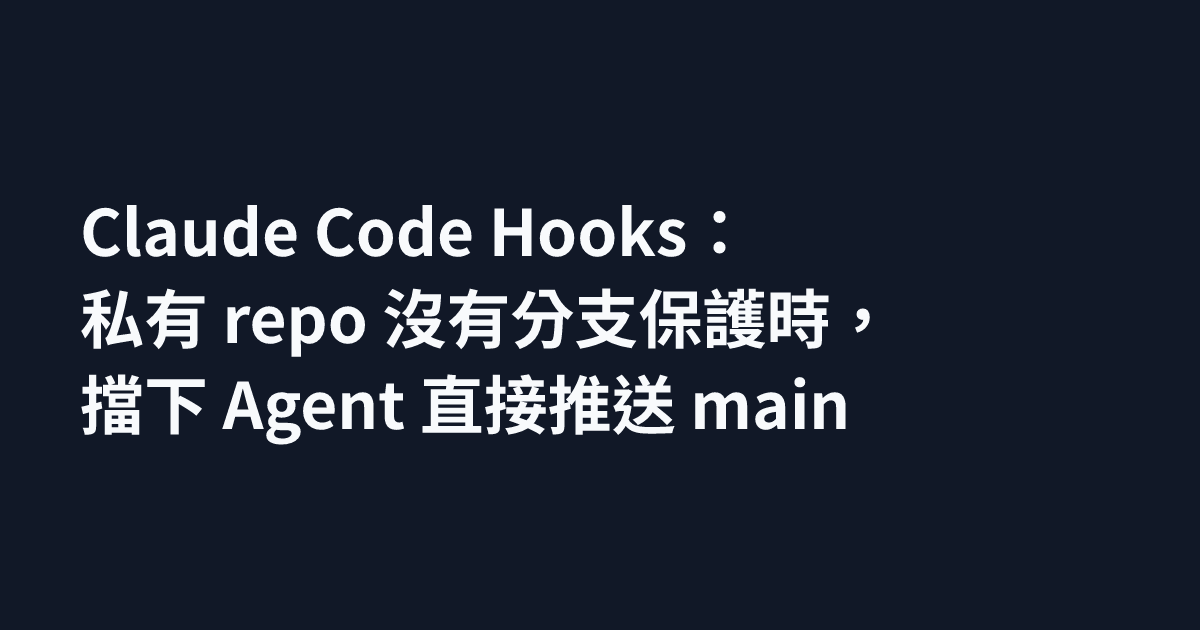
換行點不能改用 <wbr> 標記,因為 Takumi 不會在 <wbr> 換行。沒有標點的長標題會整段超出縮圖,本站有 2 個標題是這種情況。網頁上的標題也會遇到同樣的換行問題,瀏覽器的處理方式見〈網頁中文換行〉。
批次產生所有文章的縮圖
下面的腳本會讀取 content 底下每篇文章 front matter 的 title,把標題套進範本,再把 PNG 存到 og 資料夾,檔名使用文章的資料夾名稱。腳本從 node: 匯入的 glob 在 Node.js 22 以上才有。上一節的斷詞程式碼也要整段放進同一個檔案:
1import { render } from 'takumi-js';
2import { glob, mkdir, readFile, writeFile } from 'node:fs/promises';
3import { basename, dirname } from 'node:path';
4
5const font = await readFile('NotoSansTC-Bold.ttf');
6
7const escape = (text) =>
8 text.replace(
9 /[&<>"]/g,
10 (c) => ({ '&': '&', '<': '<', '>': '>', '"': '"' })[c],
11 );
12
13const card = (title) => `
14<div style="width:100%;height:100%;display:flex;align-items:center;padding:80px;background:#111827">
15 <div style="width:1040px;color:#f8fafc;font-family:'Noto Sans TC';font-size:64px;font-weight:700;line-height:1.35;word-break:keep-all;text-wrap:balance">${escape(phraseBreaks(title))}</div>
16</div>`;
17
18await mkdir('og', { recursive: true });
19for await (const file of glob('content/posts/**/index.md')) {
20 const source = await readFile(file, 'utf8');
21 const title = source.match(/^title:\s*['"]?(.+?)['"]?\s*$/m)?.[1];
22 if (!title) continue;
23 const slug = basename(dirname(file));
24 const png = await render(card(title), {
25 width: 1200,
26 height: 630,
27 fonts: [{ name: 'Noto Sans TC', data: font, weight: 700 }],
28 });
29 await writeFile(`og/${slug}.png`, png);
30}
標題要先經過 escape 處理,標題裡的 <、& 才不會被當成 HTML 標籤。腳本用正規表示式讀取標題,標題含有 YAML 跳脫的單引號時,改用 yaml 這類套件解析 front matter。用本站的 77 篇文章執行這個腳本時,包含 Node.js 啟動、載入字型與讀取文章檔,到 77 張 PNG 全部寫完約需 0.6 秒。
設定 Satori 的中文換行
Satori 的寫法與 Takumi 相近,字型一樣要從 fonts 傳入,但沒有辦法同時做到只在詞界換行與標點不落在行首。Satori 的 word 會改用 Intl 判斷的詞界換行,但標點可能落在行首,例如「套用 Linear」之後,下一行以「、Spotify」開頭,本站 77 個標題裡有 9 個出現這種情況。這個設定也只靠 Intl 斷詞,所以它切錯的詞(例如「資料|夾」)仍可能被拆開。在標點前加上禁止前後換行的 Word Joiner(U+2060)也沒有改善。只加零寬空格、不設 keep-all 時,Satori 仍把任兩個中文字之間都當成換行點,換行位置和預設相同。兩者一起設定時,畫出的文字則會互相重疊。需要標點不落在行首時,要改用 Takumi。
Satori 輸出的是 SVG,Satori 的 README 建議用 Sharp 轉成 PNG。實測紀錄表中 Satori 的時間是用 resvg-js 轉檔量的,表後另外列出改用 Sharp 時的轉檔時間。
實測紀錄
用本站 77 篇文章的標題各產生一張縮圖,統計換行的結果與每張的產生時間。「詞中換行」指換行位置落在 Intl 與 BudouX 都不認為是詞界的地方,例如「沒|有」。只有其中一方認為是詞界的位置不算在內,所以 Satori keep-all 那一列的 0 不代表沒有拆開詞。「超出寬度」是用 Takumi 的 measure() 量出每一行的右緣,只要有一行超過標題區塊寬度 1040px,這個標題就算一個:
| 做法 | 詞中換行 | 標點在行首 | 超出寬度 | 每張產生時間 |
|---|---|---|---|---|
| Takumi 預設 | 24 | 0 | 0 | 4.5ms |
Takumi keep-all 加 <wbr> |
0 | 0 | 2 | 4.3ms |
Takumi keep-all 加零寬空格 |
0 | 0 | 0 | 3.7ms |
Takumi keep-all 加零寬空格與 balance |
0 | 0 | 0 | 3.9ms |
| Satori 預設(resvg 轉 PNG) | 24 | 0 | 未量測 | 41.2ms |
Satori keep-all(resvg 轉 PNG) |
0 | 9 | 未量測 | 38.7ms |
| Satori 零寬空格(resvg 轉 PNG) | 24 | 0 | 未量測 | 42.4ms |
Takumi 加 <wbr> 那組的「詞中換行」雖然是 0,但有 2 個標題整段中文沒有換行點而超出右緣。另外用一句沒有標點的測試句「同一台電腦有好幾個專案時讓它們讀同一份模型避免重複下載佔用硬碟空間」量測,這一組的行寬達到 2112px。Satori 零寬空格那一組是在本文新增後量測的,標題共 78 個。
Satori 的時間大多花在轉成 PNG。同樣 77 個標題,只產生 SVG 時每張 2.7ms,用 Sharp 0.35.5 轉成 PNG 時每張 13.5ms,用 resvg-js 2.6.2 則每張約 39ms。從新的 Node.js 行程載入字型到產生第一張 PNG,Takumi 約 50ms,Satori 加 resvg-js 約 230ms。測試機是 4 核心的 Intel Xeon 2.30GHz。表中每張的產生時間取同一個行程裡第二輪的結果,不含第一次載入字型的時間。
總結
用 HTML 範本產生中文縮圖時,先替繪圖套件載入繁體中文字型,再在詞的邊界插入零寬空格,並禁止中文字之間換行,標題就只會在詞界換行。用 Takumi 產生本站 77 個標題的縮圖時,換行都落在兩種斷詞都認定的詞界,也沒有標點落在行首,每張約 4ms。