文章目錄
Python 讀寫文字時,如果程式沒有指定編碼,就會沿用作業系統的預設編碼。Mac 的預設編碼是 UTF-8,繁體中文 Windows 則是 cp950(微軟版本的 Big5),因此在 Mac 上能正常執行的腳本,放到 Windows 讀寫中文或 emoji 時,會出現 'cp950' codec can't decode 或 can't encode 的錯誤。我的專案都在 Mac 上開發,放到 Windows 讓 AI Agent 執行就出錯,每次都要手動在程式裡補上編碼。我們只要替 Windows 帳號設定一次環境變數來開啟 Python 的 UTF-8 模式,之後在這台電腦執行的 Python 都會預設用 UTF-8,同一份腳本不用修改就能在兩邊執行。
測試環境是 Windows 11 繁體中文版,終端機是 Windows Terminal 裡的 Windows PowerShell。示範的 report.py 和 Mac 上常見的寫法一樣,讀寫檔案時沒有指定編碼,它會讀取含有中文與 ☕ 的 UTF-8 檔案,整理出待辦事項後印出完成訊息。
cp950 錯誤訊息與 Python 版本
Python 3.14 以下的程式沒有指定編碼時,在繁體中文 Windows 上會用 cp950 讀寫文字,遇到 cp950 無法處理的內容時,依動作會出現三種錯誤。訊息裡的位元組與位置會隨內容不同:
| 錯誤訊息 | 發生的動作 |
|---|---|
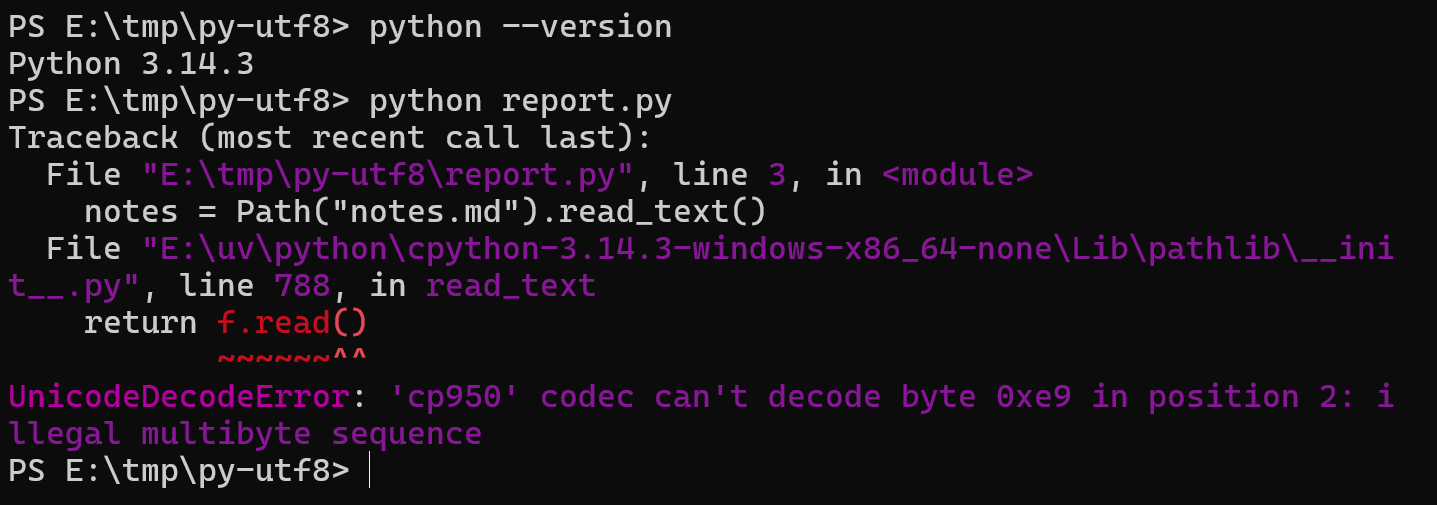
UnicodeDecodeError: 'cp950' codec can't decode byte 0xe9 in position 2: illegal multibyte sequence |
讀取 UTF-8 的文字檔 |
UnicodeEncodeError: 'cp950' codec can't encode character '\u2615' in position 2: illegal multibyte sequence |
寫入的文字含有 cp950 沒有的字,例如 emoji |
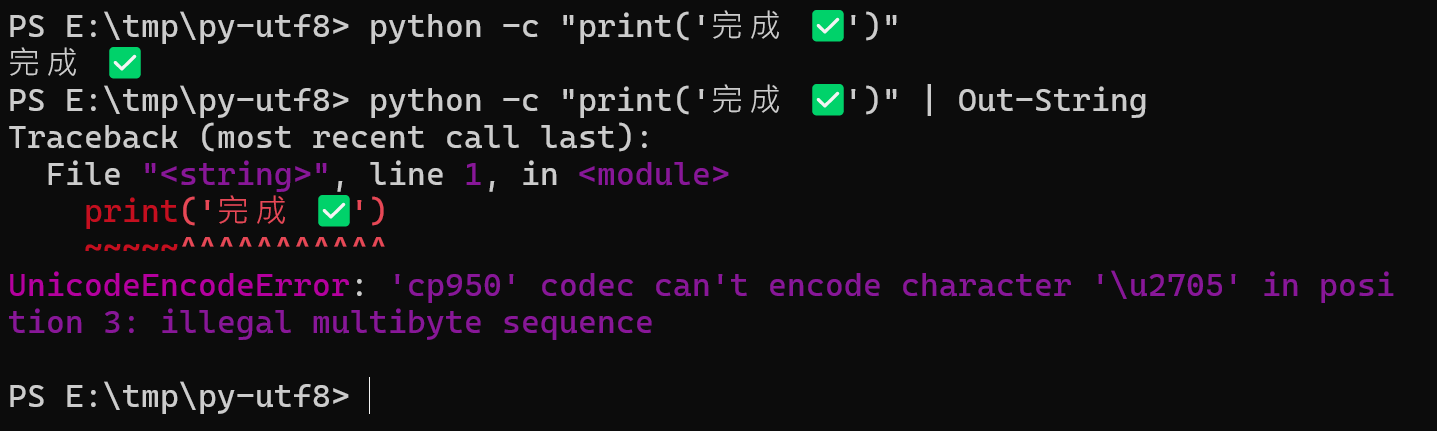
UnicodeEncodeError: 'cp950' codec can't encode character '\u2705' in position 3: illegal multibyte sequence |
print 的輸出交給 AI Agent 或其他程式接收 |
第三種錯誤只在輸出由其他程式接收時出現,因此我們自己在終端機執行正常,交給 AI Agent 執行才會失敗。在 Python 3.14 執行 report.py 時,讀取檔案的 read_text() 就會出現第一種錯誤:
Python 3.15 起依 PEP 686 預設開啟 UTF-8 模式,PEP 686 也說明這項改變主要影響 Windows 使用者。我們先在終端機執行 python --version 看腳本用的版本,再對照自己的情況:
| 情況 | 原因 | 實測結果 | 處理方式 |
|---|---|---|---|
python --version 是 3.14 以下 |
沒有指定編碼時用 cp950 | 3.10、3.12、3.14 執行 report.py 都出錯 |
開啟 UTF-8 模式 |
python --version 是 3.15 以上 |
預設用 UTF-8 | 3.15.1 執行 report.py 正常 |
不用設定 |
| 電腦裝了 3.15,仍出現 cp950 錯誤 | 專案用的是舊版,例如 uv 專案的 .python-version 固定在 3.12 |
uv run 執行的 3.12.13 沒有開啟 UTF-8 模式 |
用 uv run python --version 確認後開啟 UTF-8 模式 |
開啟 UTF-8 模式或改用 3.15 後,出現 'utf-8' codec can't decode |
讀到 cp950 的資料 | cmd /c ver 的輸出與 Big5 舊檔都讀不出來 |
讀取時指定編碼,見後面的「UTF-8 模式下的 cp950 資料」 |
UTF-8 模式的環境變數
版本在 3.14 以下時,在終端機執行這行指令,替目前的 Windows 帳號新增 PYTHONUTF8 環境變數,值設為 1:
1setx PYTHONUTF8 1
出現「成功: 已經儲存指定的值。」就完成了。這個變數存在目前帳號的使用者環境變數,不需要系統管理員權限,也不影響電腦上的其他帳號,Python 3.7 起的版本都會讀取它。
值只能是 1 或 0。寫成 true 這類其他值時,Python 會無法啟動並顯示 Fatal Python error: preconfig_init_utf8_mode: invalid PYTHONUTF8 environment variable value,這時再執行一次 setx PYTHONUTF8 1 就能改正。
確認 UTF-8 模式已生效
執行 setx 前就開著的終端機讀不到新的值。在同一個視窗執行這行指令確認 UTF-8 模式,印出 0 代表還沒開啟:
1python -c "import sys; print(sys.flags.utf8_mode)"
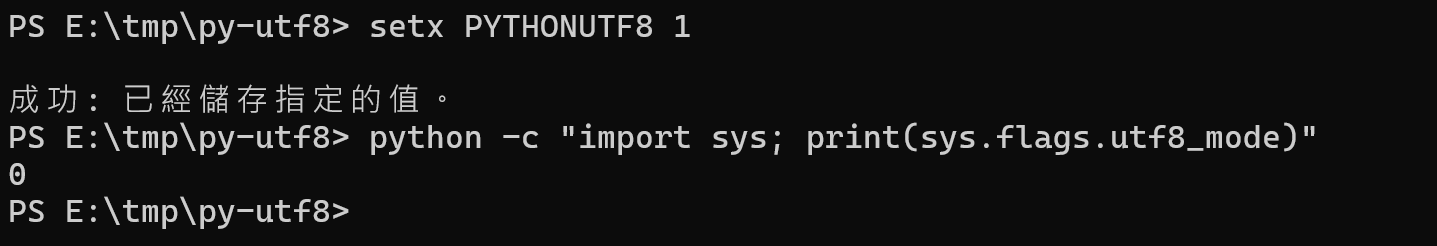
關掉終端機,從開始功能表重新開啟後再執行一次,印出 1 就代表已經開啟,report.py 也能讀寫中文並印出 ✅:
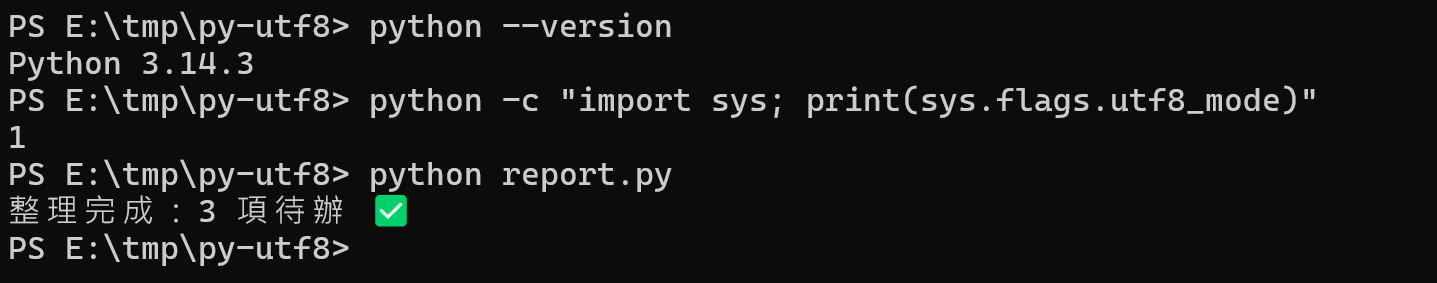
AI Agent 的應用程式也要重新開啟。實測設定前就開著的 Claude 桌面版,它執行的指令仍然讀不到 PYTHONUTF8,要把應用程式完全結束再重新開啟。
要還原時,在 PowerShell 執行這行刪除變數,再重新開啟終端機:
1[Environment]::SetEnvironmentVariable("PYTHONUTF8", $null, "User")
UTF-8 模式下的 cp950 資料
開啟 UTF-8 模式或改用 Python 3.15 之後,沒有指定編碼的程式反過來會把 cp950 的資料當成 UTF-8 解讀,並出現 'utf-8' codec can't decode byte 的錯誤。實測遇到兩種情況:
| 情況 | 錯誤訊息 | 處理方式 |
|---|---|---|
用 subprocess 讀取 ipconfig、cmd /c ver 這類 Windows 內建指令的輸出 |
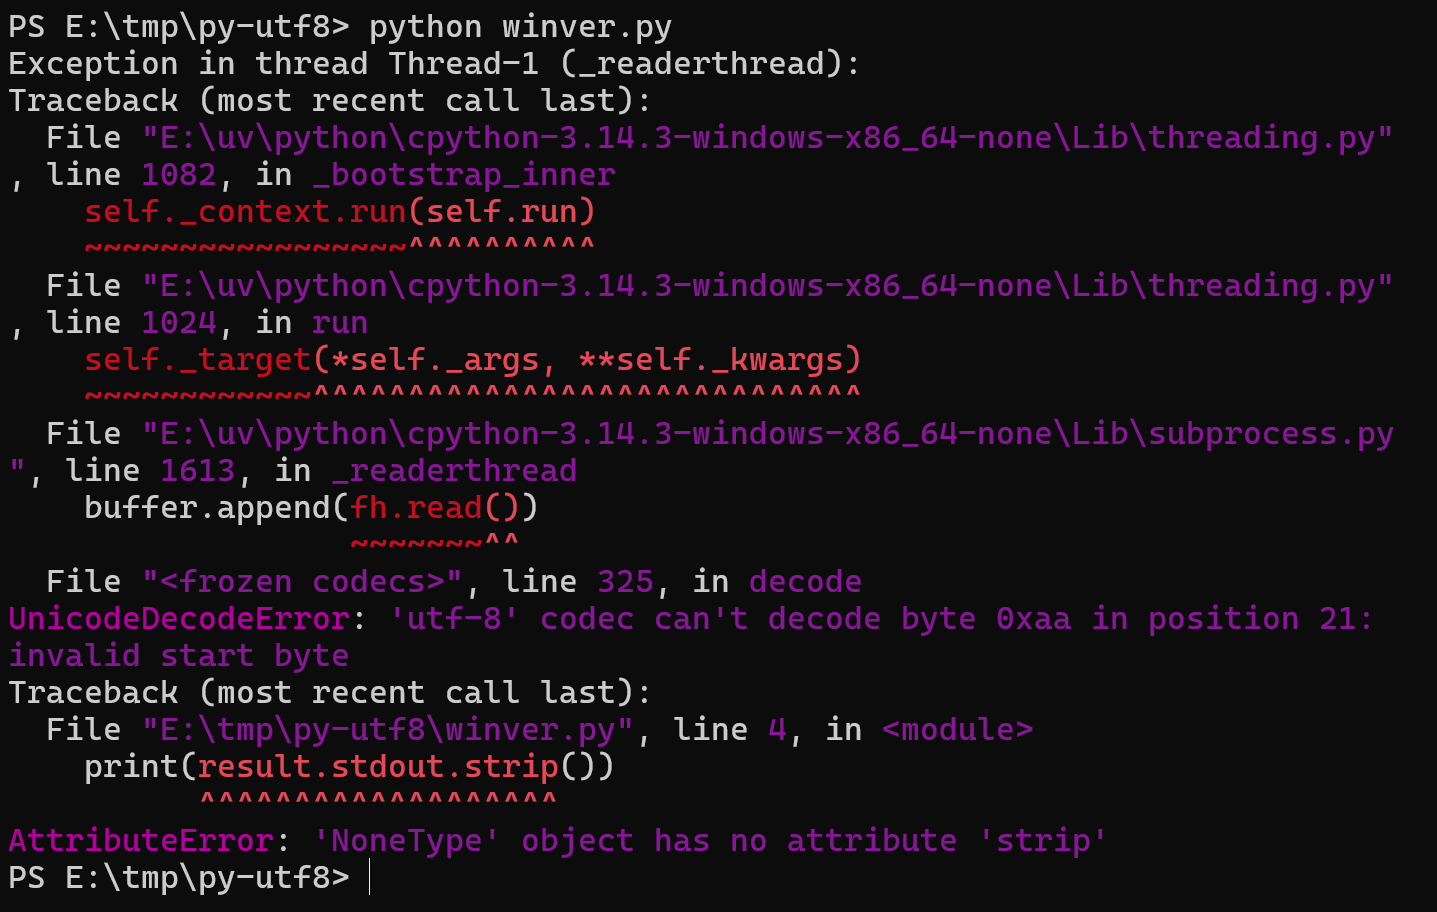
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xaa in position 21: invalid start byte |
加上 encoding="locale" |
| 讀取以 Big5 存檔的舊檔案 | UnicodeDecodeError: 'utf-8' codec can't decode byte 0xab in position 0: invalid start byte |
open() 加上 encoding="cp950" |
Windows 內建指令在繁體中文 Windows 上仍然輸出 cp950。下面的 winver.py 用 cmd /c ver 取得 Windows 版本:
1import subprocess
2
3result = subprocess.run(["cmd", "/c", "ver"], capture_output=True, text=True)
4print(result.stdout.strip())
開啟 UTF-8 模式後執行,讀取輸出的執行緒先出現 UnicodeDecodeError,result.stdout 因此變成 None,接著 print 那一行又出現 AttributeError:
在 subprocess.run 加上 encoding="locale" 後,Python 會用系統的編碼讀取指令的輸出,正確印出 Microsoft Windows [版本 10.0.26300.9711]。這個參數從 Python 3.10 起可以使用,有沒有開啟 UTF-8 模式都能正確讀取:
1result = subprocess.run(["cmd", "/c", "ver"], capture_output=True, text=True, encoding="locale")
實測紀錄
測試用 uv 安裝的 3.10.22、3.12.13、3.14.3,以及 python.org 的 Python install manager 安裝的 3.15.1。示範的 report.py 如下,notes.md 是一份會議紀錄:
1from pathlib import Path
2
3notes = Path("notes.md").read_text()
4todos = [line[2:] for line in notes.splitlines() if line.startswith("- ")]
5Path("todo.md").write_text("".join(f"[ ] {t}\n" for t in todos))
6print(f"整理完成:{len(todos)} 項待辦 ✅")
各版本執行其他動作的結果:
| 動作 | 3.10、3.12、3.14 預設 | 3.14 設定 PYTHONUTF8=1 |
3.15.1 預設 |
|---|---|---|---|
| 寫入 ☕ | cp950 編碼錯誤 | 存成 UTF-8 | 存成 UTF-8 |
print emoji 到管線 |
cp950 編碼錯誤 | 正常 | 正常 |
subprocess 讀取 cmd /c ver |
正常 | UTF-8 解碼錯誤 | UTF-8 解碼錯誤 |
| 讀取 Big5 的 CSV | 正常 | UTF-8 解碼錯誤 | UTF-8 解碼錯誤 |
同一行 print 直接執行時正常,接上管線後就出現 cp950 編碼錯誤:
其他設定與執行方式的結果:
| 測試條件 | 結果 |
|---|---|
讓 Claude Code 用 3.14.3 執行 print("完成 ✅") |
cp950 編碼錯誤 |
3.14.3 只設定 PYTHONIOENCODING=utf-8 |
標準輸入、輸出與錯誤輸出改用 UTF-8,讀取 notes.md 仍是 cp950 錯誤 |
3.14.3 加上 -X utf8 |
只有那一次執行使用 UTF-8 模式 |
uv 專案固定在 3.12.13,設定 PYTHONUTF8=1 |
uv run 的 sys.flags.utf8_mode 從 0 變成 1 |
3.15.1 設定 PYTHONUTF8=1 |
與預設相同 |
3.15.1 設定 PYTHONUTF8=0 或加上 -X utf8=0 |
讀取 notes.md 又出現 cp950 錯誤 |
刪除 PYTHONUTF8 後新開的終端機 |
3.14.3 回到 0,3.15.1 仍是 1 |
總結
Mac 上寫的 Python 腳本在繁體中文 Windows 出現 cp950 錯誤時,替 Windows 帳號開啟一次 Python 的 UTF-8 模式,就不用逐一修改腳本。實測設定後重新開啟的終端機裡,原本讀取失敗的 report.py 能正常讀寫中文與 emoji。
延伸閱讀